
인공지능에게 업무를 지시할 때 모호하고 일반적인 질문을 던지면 당연히 교과서적인 뻔한 답변만 돌아옵니다. 프롬프트 엔지니어링은 복잡한 코딩 기술이 아니라, 업무의 맥락과 제약 조건을 명확히 전달하여 원하는 형식의 결과물을 한 번에 얻어내는 커뮤니케이션 기술입니다. 본 글에서는 OpenAI의 공식 프롬프트 엔지니어링 가이드를 기반으로 실무에 즉시 적용 가능한 5단계 조립 공식과 직무별 템플릿을 소개합니다.
프롬프트를 체계화하는 5단계 구성 요소
실무에서 높은 완성도의 결과물을 이끌어내는 프롬프트는 우연히 만들어지지 않습니다. 다음 5가지 핵심 구성 요소를 순차적으로 조립할 때 모호함을 없애고 원하는 결과물을 단 한 번에 도출할 수 있습니다.
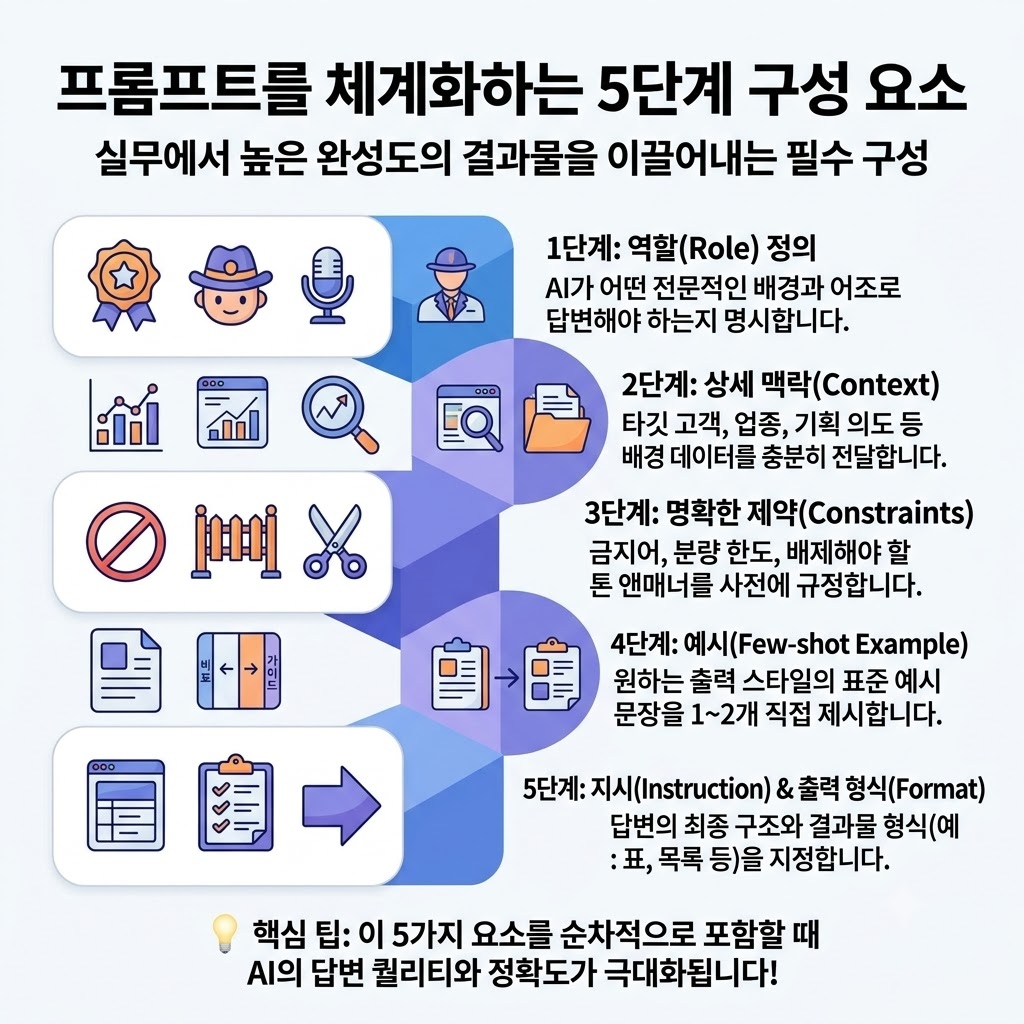
역할(Role) 정의
AI가 어떤 전문적인 배경과 어조로 답변해야 하는지 명시합니다.
예: “너는 10년 차 B2B SaaS 시니어 프로덕트 매니저야”
상세 맥락(Context)
타깃 고객, 업종, 기획 의도 등 충분한 배경 정보와 상황 데이터를 전달합니다.
예: “예산 절감을 고민하는 중소기업 실무진 대상 기획안이야”
명확한 제약(Constraints)
금지어, 분량 한도, 배제해야 할 톤앤매너 등 필수 제한 조건을 사전에 규정합니다.
예: “전문 용어를 남발하지 말고, 불필요한 서론은 생략해”
예시(Few-shot Example)
원하는 출력 스타일과 문체의 표준 예시 문장을 1~2개 직접 제시합니다.
예: “아래 제공하는 모범 작성 샘플의 형식과 톤을 준수해”
지시(Instruction) & 출력 형식(Format)
답변의 최종 구조와 결과물 형식(예: 마크다운 표, 번호 매겨진 목록, JSON 등)을 명확하게 지정합니다.
예: “결과물은 3개 열(구분, 핵심 내용, 기대 효과)을 가진 마크다운 표로 정리해”
💡 핵심 팁: 5대 요소 순차 조립의 효과
이 5가지 요소를 순차적으로 포함할 때 AI의 할루시네이션(환각)은 사전에 차단되고 답변의 퀄리티와 실무 적합도가 극대화됩니다!
Few-Shot 예시 제공을 통한 답변 품질 극대화 기법
프롬프트 엔지니어링에서 제로샷(Zero-Shot, 예시 없이 질문만 던지는 방식)보다 답변의 일관성을 비약적으로 높이는 기법이 바로 퓨샷(Few-Shot, 2~3개의 모범 입출력 샘플을 함께 제공하는 방식)입니다.
특히 정형화된 업무 양식이 정해져 있는 경우, 원하는 출력 형태의 샘플을 프롬프트 안에 명시해 주면 모델은 규칙을 스스로 추론하여 동일한 톤앤매너와 구조로 결과를 작성합니다.
– 입력: “서버 점검으로 내일 새벽 2시부터 4시까지 서비스 접속 불가”
– 출력: “[공지] 시스템 정기 점검 안내 (04/15 02:00~04:00) – 서비스 이용이 일시 중단됩니다.”
[입출력 모범 예시 2]
– 입력: “신규 결제 모듈 도입으로 해외 카드 결제 수수료 인하”
– 출력: “[업데이트] 해외 결제 수수료 인하 안내 – 더 편리해진 결제 환경을 경험해보세요.”
[실제 작업 요청]
– 입력: “모바일 앱 2.4.0 버전 배포로 다크 모드 기능 추가 및 푸시 알림 버그 수정”
– 출력:
이처럼 명확한 예시가 주어지면 AI는 부연 설명이나 사족 없이 즉시 지정된 규격의 제목과 요약문만을 반환하게 되므로 후가공 시간을 크게 단축할 수 있습니다. 자세한 기법은 OpenAI 공식 프롬프트 가이드에서 확인할 수 있습니다.
Chain-of-Thought(생각의 사슬)를 활용한 복합 추론 유도
단순한 질의응답이 아닌 수학적 계산, 논리적 모순점 분석, 비즈니스 손익 분기점 추정 등 복합적인 판단이 필요한 경우, “단계별로 차근차근 생각해 보세요(Think step by step)”라는 문구를 추가하는 것만으로도 모델의 추론 오류를 크게 낮출 수 있습니다.
모델이 즉각적으로 최종 결론을 도출하려 하면 중간 계산 과정에서 오류가 발생하기 쉽지만, 중간 추론 과정을 텍스트로 풀어내도록 유도하면 선행 문맥을 토대로 다음 단계를 검증하며 논리를 전개하기 때문에 최종 도출 결과의 신뢰도가 크게 높아집니다. 복합 분석 과제를 테스트할 때는 OpenAI Playground 공식 테스트 환경을 활용하여 파라미터별 차이를 검증해 보실 수 있습니다.
실무에서 흔히 범하는 3대 프롬프트 실수와 해결책
| 흔한 실수 유형 | 발생하는 문제점 | 실무 개선 해결책 |
|---|---|---|
| 모호한 길이 요청 (“적당히 요약해 줘”) | 너무 짧거나 장황한 불규칙한 답변 생성 | “공백 포함 500자 이내, 불릿 포인트 3개로 작성”과 같이 정량 조건 지정 |
| 부정문 중심의 지시 (“어렵게 쓰지 마”) | 모델이 피해야 할 행동에 집중하다 문맥 혼란 유발 | “중학생도 이해할 수 있는 쉬운 일상 어휘로 설명해 줘”처럼 긍정형 지침 사용 |
| 구분자(Delimiter) 누락 | 명령어와 참조 본문이 뒤섞여 엉뚱한 맥락 해석 | 따옴표("""), 백틱(“`), 태그(<context>)로 데이터 영역을 명확히 격리 |
프롬프트 제약이 통하지 않는 모델의 한계와 탈출 기법
아무리 정교하게 프롬프트를 설계하더라도 LLM의 본질적인 확률론적 토큰 생성 특성상 발생하는 한계 상황이 존재합니다. 다음과 같은 상황에서는 프롬프트 문구 수정에 시간을 낭비하기보다 구조적 접근법을 전환해야 합니다.
- 엄격한 산술 연산 및 회계 계산: 대규모 언어 모델은 수학 엔진이 아니므로 복잡한 세무 계산이나 대차대조표 합산 시 프롬프트만으로는 오차가 발생할 수 있습니다. 이 경우 Code Interpreter(파이썬 코드 실행) 기능을 활성화하여 실제 계산을 파이썬 스크립트에 위임해야 합니다.
- 과도한 부정문 제약 충돌: “~하지 마시오”라는 부정 명령어가 5개 이상 중첩되면 모델의 어텐션 메커니즘이 교란되어 오히려 금지된 단어를 생성하는 현상이 발생합니다. 부정문을 “오직 A와 B 양식만을 사용하여 작성하시오”와 같은 긍정형 지시문으로 치환해야 합니다.
- 추론 깊이의 한계: 10단계 이상의 복합적인 비즈니스 논리 추론이 필요한 경우 범용 모델 대신 OpenAI o1이나 o3 계열의 전문 추론(Reasoning) 모델로 스위칭하여 생각의 사슬(Chain-of-Thought) 토큰을 강제로 할당하는 것이 효과적입니다.
출력 형식(Output Format) 확정
마크다운 표, 불렛포인트, JSON 데이터 구조 등 원하는 레이아웃을 지정합니다.
실무 Before & After 프롬프트 대조
동일한 목적이라도 프롬프트를 어떻게 작성하느냐에 따라 AI가 도출하는 결과물의 수준은 극명하게 갈립니다. 다음은 실제 사무용 마우스 마케팅 카피 작성을 의뢰했을 때의 모호한 질문(Before)과 5단계 구조화 프롬프트(After)의 실무 대조 예시입니다.
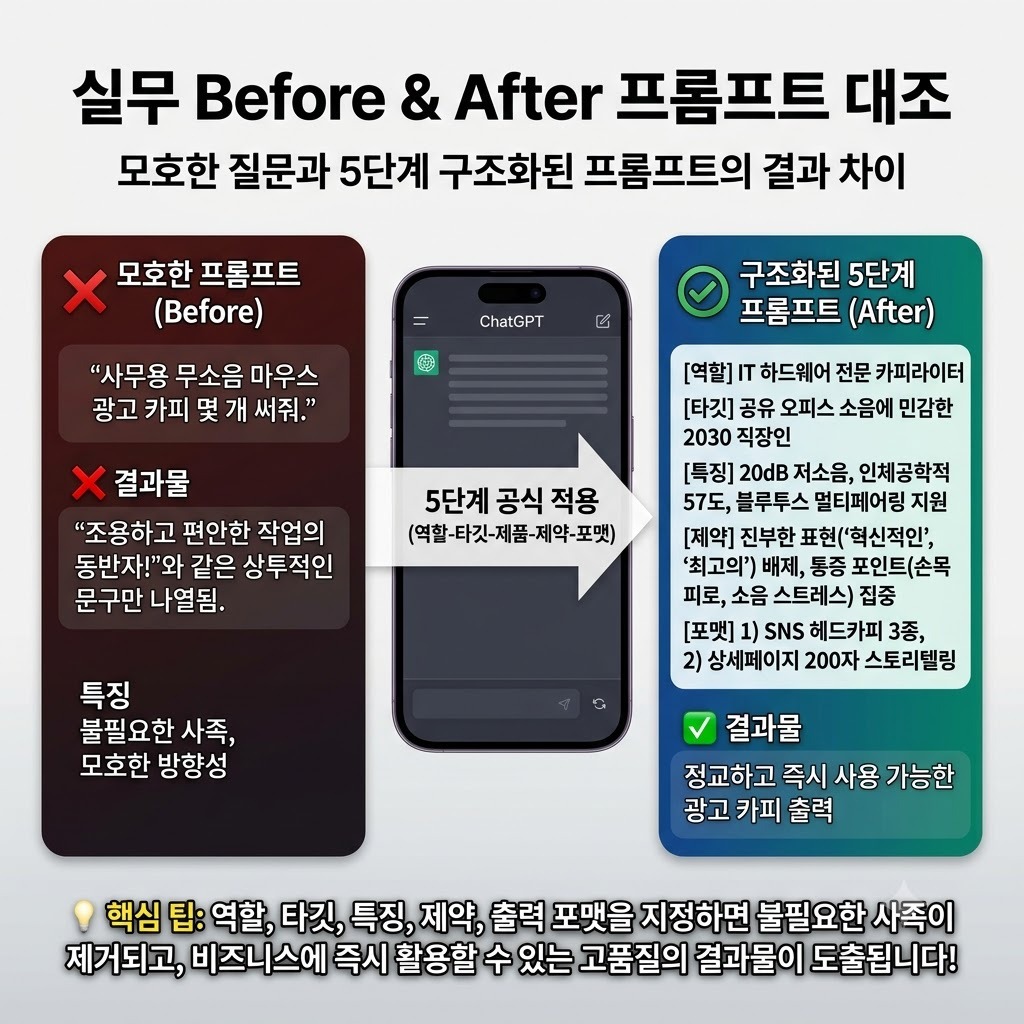
❌ 모호한 프롬프트
❌ AI 결과물
“조용하고 편안한 작업의 동반자!”, “당신의 사무실을 더 스마트하게!”와 같은 상투적이고 뻔한 문구만 나열됨.
✅ 구조화된 5단계 프롬프트
[타깃] 공유 오피스 소음에 민감한 2030 직장인
[특징] 20dB 저소음, 인체공학적 57도, 블루투스 멀티페어링 지원
[제약] 진부한 표현(‘혁신적인’, ‘최고의’) 배제, 통증 포인트(손목 피로, 소음 스트레스) 집중
[포맷] 1) SNS 헤드카피 3종, 2) 상세페이지 200자 스토리텔링
✅ AI 결과물
타깃 페인포인트를 정확히 타격하는 정교하고 즉시 사용 가능한 광고 카피 출력.
💡 핵심 팁: 5단계 공식이 만드는 비즈니스 생산성의 격차
역할, 타깃, 특징, 제약, 출력 포맷을 지정하면 불필요한 사족이 제거되고, 비즈니스에 즉시 활용할 수 있는 고품질의 결과물이 도출됩니다!
추론 신뢰도를 높여주는 핵심 유도 문구
복잡한 문제 해결이나 전략 수립 시, 답변을 바로 요구하기보다 “단계별로 추론하고 그 근거를 설명해달라(Chain-of-Thought)”는 지침을 추가하면 논리적 비약이 크게 줄어듭니다. 더 다양한 실습 템플릿과 고급 기법은 OpenAI Cookbook 공식 저장소에서 추가로 확인하실 수 있습니다.